
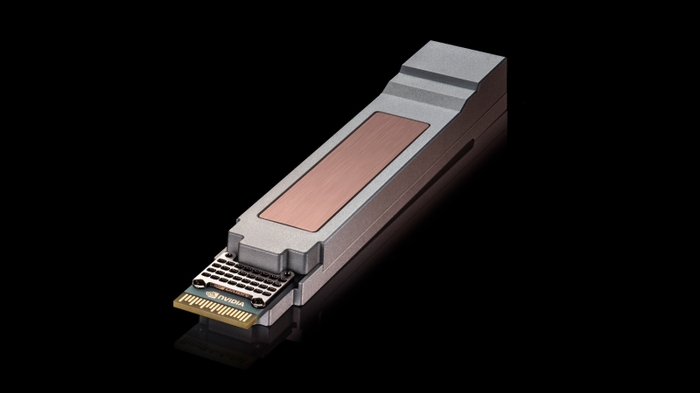
NVIDIA가 Cisco와 차세대 AI 팩토리의 하드웨어 생태계를 지원하기 위해 레인당 400Gb/s를 지원하는 새로운 고밀도 광모듈 USFP(Ultra-Dense Small Form Factor Pluggable)의 개발 계획을 발표했습니다. USFP는 플러그형 트랜시버 기반의 차세대 AI 팩토리를 위해 설계됐습니다.
AI 모델이 점점 커지고 추론 수요가 확대됨에 따라, AI 팩토리는 네트워크의 복잡성, 전력, 비용을 관리하면서 더 많은 컴퓨팅 시스템을 연결해야 하죠. 와트 및 스위치당 더 많은 데이터를 전송함으로써 운영자는 인프라 투자 효율성을 높일 수 있습니다.
AI 팩토리를 확장하려면 연결당 더 많은 대역폭과 스위치당 더 많은 연결이 필요합니다. 스위치 용량이 한계에 도달하면 네트워크를 추가로 확장하기 위해 스위치 계층과 광링크가 추가로 필요할 수 있으며, 이로 인해 지연 시간, 전력 소비, 비용이 증가할 수 있습니다.
USFP는 AI 팩토리 구축업체들이 레인당 200Gb/s에서 400Gb/s의 이더넷 AI 패브릭으로 확장할 수 있도록 설계됐습니다. 동시에 여러 세대의 데이터센터 네트워크에서 대규모로 검증된 배포 모델을 확장하죠. 이를 통해 고객은 데이터센터 인프라를 전면 개편하지 않고도 차세대 광학 기술을 도입하고 AI 워크로드의 성능 요구사항을 충족할 수 있습니다.
처음 선보일 USFP 기반 트랜시버는 스위치와 SuperNIC를 모두 지원하는 OSFP(Octal Small Form Factor) 크기의 폼팩터에 16개의 전이중(full-duplex) 레인을 탑재하며, 향후 32개 이상의 레인으로 확장할 수 있도록 설계될 예정입니다. USFP는 레인 수와 레인당 대역폭을 모두 두 배로 늘려, 추가적인 네트워크 계층 없이도 AI 패브릭이 더 많은 1.6Tb/s 엔드포인트를 연결할 수 있도록 지원합니다. 이를 통해 고객은 USFP로 총 12.8Tb/s의 용량을 확보할 수 있습니다.
OSFP 크기의 모듈과 비교했을 때, USFP는 레인당 200Gb/s의 플러그형 모듈 대비 4배 높은 대역폭과 전면 패널 대역폭 밀도, 약 1.3배 높은 전력 효율을 제공합니다. 이를 통해 AI 구축 기업은 동일한 네트워크 설치 공간 내에서 컴퓨팅 규모를 확장하는 동시에, AI 팩토리 전체 전력 예산에서 네트워킹이 차지하는 비중을 줄일 수 있습니다.
NVIDIA 수석 부사장 Gilad Shainer는 “세계 최대 규모의 AI 팩토리를 구축하는 것은 가장 작은 연결을 재고하는 것에서 시작된다”며, “NVIDIA와 Cisco는 USFP를 통해 플러그형 광통신 기술을 혁신하기 위한 생태계를 구축하고 있습니다. 이를 통해 더 많은 컴퓨팅 시스템을 더욱 효율적으로 연결해 차세대 AI 팩토리에 동력을 공급할 것입니다”라고 말했습니다.
Cisco 광시스템 및 광학 부문 수석 부사장 겸 총괄 Bill Gartner는 “AI 인프라 구축 기업은 복잡한 운영 모델에 얽매이지 않으면서도 성능을 확장할 수 있는 상호연결 아키텍처가 필요하다”며, “Cisco와 NVIDIA는 플러그형 광통신 기술을 레인당 400Gb/s로 확장하기 위해서는 기존 모듈 설계의 점진적 개선만으로는 충분하지 않다고 판단했습니다. 양사의 협력을 통해 개발되는 USFP는 플러그형 광통신 기술의 유지보수성, 구축 유연성, 운영 간소화를 유지하면서 새로운 차원의 대역폭 밀도를 제공하도록 설계됐죠. 실리콘과 시스템부터 광통신 기술, 네트워크 운영체제에 이르는 풀스택 접근 방식을 통해 모든 계층을 최적화함으로써 차세대 AI 네트워크에 필요한 성능과 확장성을 제공할 것입니다”라고 말했습니다.
모든 스위치에서 더 많은 AI 인프라 제공
USFP는 레인당 400Gb/s의 전기 신호를 처리하도록 설계됐으며, 모듈 삽입 후 고속 접점을 결합하는 2단계 삽입 구조의 새로운 2차원 배열 커넥터를 사용합니다. 이를 통해 접점 마모를 줄이고, 신호 무결성을 향상시키며, 모듈 삽입에 필요한 힘을 예측 가능하게 합니다. 해당 커넥터 기술을 통해 레인 수를 32개의 전이중 레인으로 확장할 수 있으며, 향후 더 많은 레인 수로 확장할 수 있죠. 또한 400Gb/s 성능을 기준으로 설계돼 레인당 200Gb/s 환경에서도 향상된 성능을 제공합니다.
USFP는 트랜시버 내에 별도의 전용 냉각 회로를 내장하지 않고도 최대 100W의 열 방출을 지원할 수 있어, 스위치 설계의 복잡성을 줄이고 신뢰성을 높입니다. 이러한 기능들을 통해 기존 플러그형 트랜시버의 검증된 배포, 유지보수성, 제조성을 유지하면서도 더 높은 대역폭의 패브릭을 구현할 수 있습니다.
모든 USFP 구성은 신호 처리를 간소화해 지연 시간과 전력 소비를 줄이는 광통신 설계를 지원합니다. 다양한 광학 기술과 연결 거리를 폭넓게 지원해 시스템 설계자는 AI 팩토리의 고유한 구축 요구사항에 유연하게 대응할 수 있도록 합니다.
차세대 AI 팩토리를 위한 하드웨어 생태계
NVIDIA와 Cisco는 TE Connectivity와 Amphenol과 협력해 USFP 케이지, 커넥터, 모듈을 개발하고 있으며, 향후 추가 파트너들도 참여할 예정입니다. 이러한 공통 폼팩터는 공급업체들에게 레인당 400Gb/s 패브릭을 위한 고밀도 플러그형 인프라를 개발할 수 있는 공통 기반을 제공함으로써, AI 팩토리 구축 기업을 위한 견고한 생태계를 조성합니다.
이번 협력은 NVIDIA Spectrum-X™ Ethernet 네트워킹과 Cisco Silicon One 기반 이더넷 네트워크 간 원활한 연동을 보장하기 위한 NVIDIA와 Cisco의 기존 협력을 기반으로 합니다. 이를 통해 기업, 네오클라우드, 소버린 클라우드의 AI 인프라 구축을 간소화합니다.
NVIDIA와 Cisco는 향후 커뮤니티 주도의 멀티소스 프로젝트를 통해 USFP에 대한 개방형 산업 표준 규격을 마련할 계획입니다.