
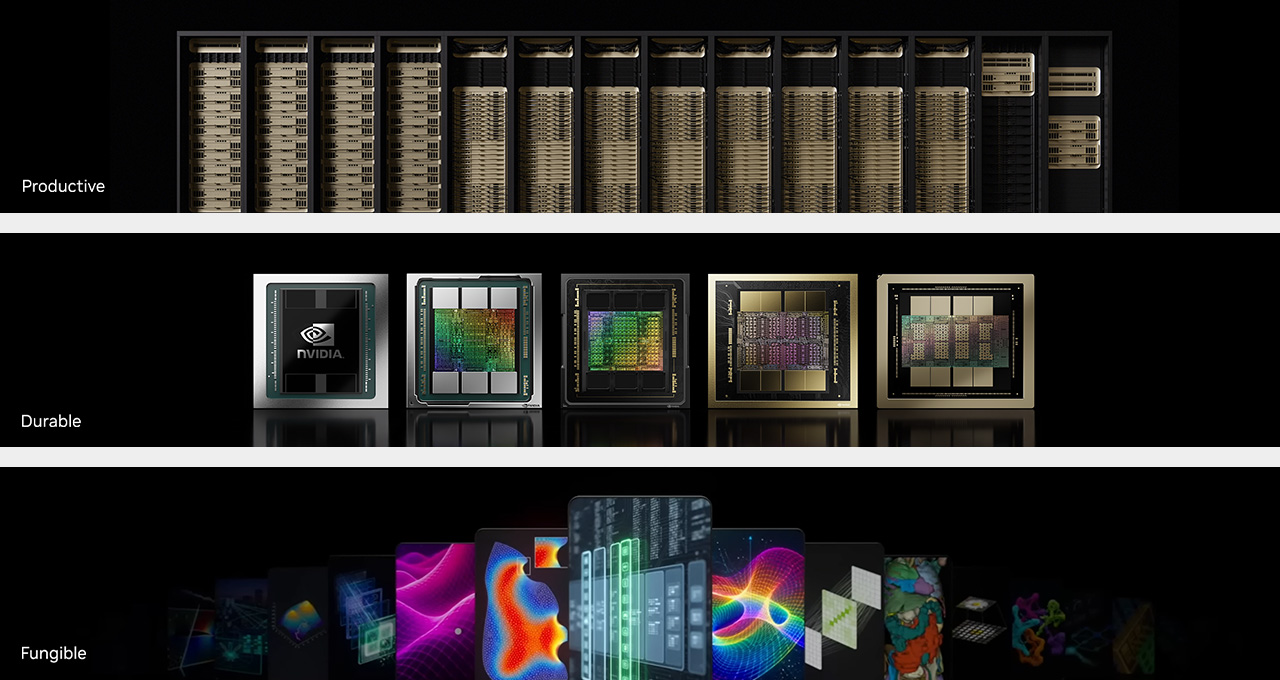
AI 팩토리는 메가와트, 나아가 기가와트 단위로 구축됩니다. 메가와트급 AI 팩토리 하나를 구축하는 데는 약 6,000만 달러가 소요되며, AI 팩토리 운영 기업은 투자수익률(ROI)에 대한 명확한 전망이 있어야만 이처럼 대규모 자본 투자를 결정할 수 있죠. AI 팩토리의 수익률을 결정하는 세 가지 핵심 요소는 다음과 같습니다.
- 수익 창출 능력: AI 팩토리가 생산 가능한 모든 토큰을 판매한다고 가정했을 때 1년 동안 창출할 수 있는 수익
- 유효 수명: AI 하드웨어가 지속적으로 수익을 창출할 수 있는 기간
- 수요: AI 팩토리가 생산하는 토큰에 대한 수요 규모
한 요소의 강점만으로 다른 요소의 약점을 완전히 상쇄할 수는 없습니다. 높은 수익 창출 능력을 갖췄더라도 생산 가능한 토큰의 일부만 판매한다면 그 의미가 줄어들죠. 수요가 높더라도 불과 1년 만에 최대 생산 능력을 유지하지 못한다면 마찬가지입니다. 이 세 가지는 독립적인 요소가 아닙니다. 더 다양한 워크로드를 처리할 수 있는 AI 팩토리는 더 많은 수요를 확보할 수 있으며, 이를 통해 해마다 지속적으로 수익을 창출할 수 있습니다.
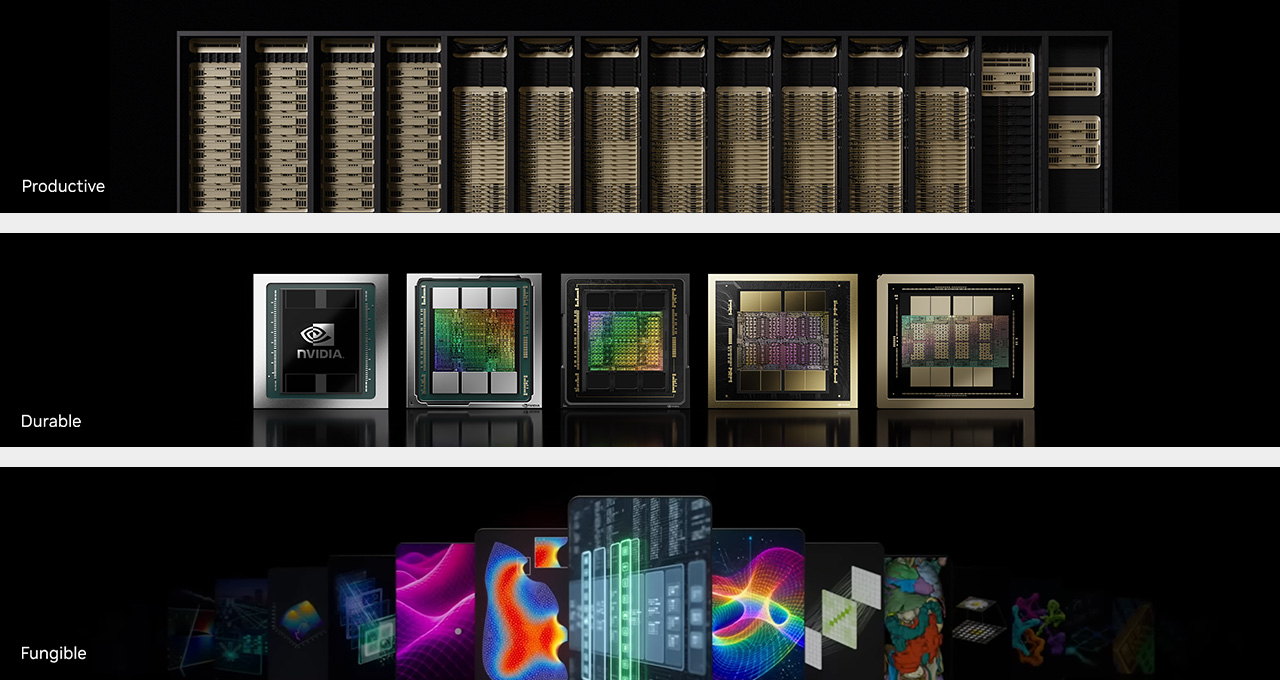
NVIDIA AI 팩토리는 이 세 가지 요소를 모두 극대화하도록 설계됐습니다. 주요 특징은 다음과 같습니다.
- 생산성: 메가와트당 최고 수준의 처리량과 최저 수준의 토큰당 비용을 제공해 수익 창출 능력을 극대화합니다.
- 내구성: NVIDIA GPU와 시스템은 출하 후에도 수년 동안 지속적으로 수익을 창출해 유효 수명을 연장합니다.
- 범용성: 모든 단계와 환경에서 모든 유형의 AI는 물론, AI와 직접 관련되지 않은 다양한 워크로드까지 처리할 수 있어, 대응 가능한 수요의 범위와 규모를 확대합니다.
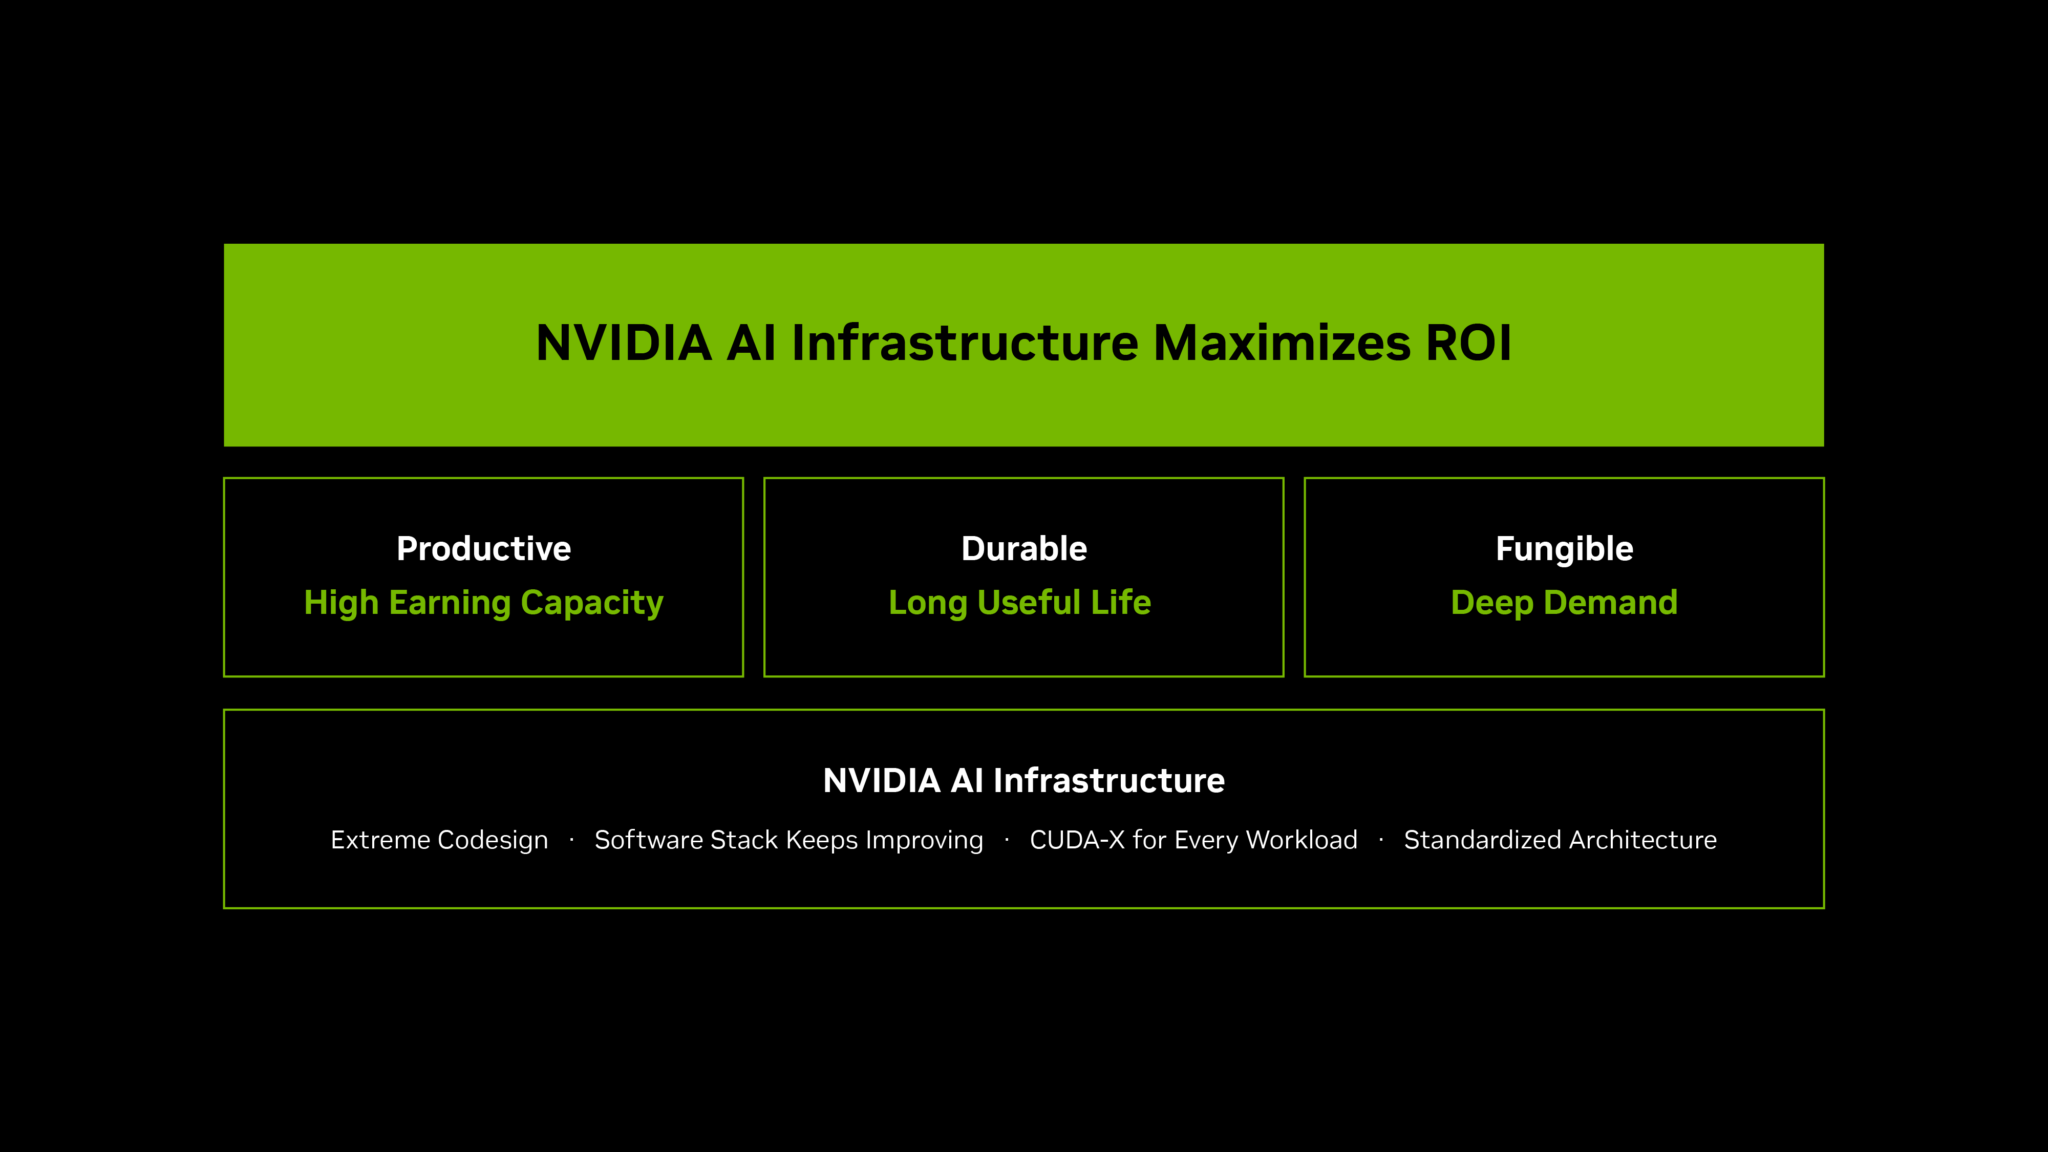
풀스택에 걸친 엔지니어링 공동 설계는 AI 팩토리의 처리량을 극대화하며, 지속적인 소프트웨어 최적화를 통해 구축된 하드웨어가 출하 후 수년이 지나도 높은 생산성을 유지할 수 있도록 합니다. NVIDIA CUDA-X 라이브러리는 AI 팩토리에서 모든 종류의 가속 컴퓨팅 워크로드를 실행할 수 있도록 지원하는데요. 여기에 표준화된 아키텍처를 기반으로 검증된 레퍼런스 설계를 배포할 수 있어, 모든 운영자가 이를 손쉽게 활용할 수 있습니다.
생산성: 메가와트당 최대 토큰 처리량과 최저 토큰 비용
전력은 AI 팩토리의 확장을 제한하는 결정적인 제약 요소입니다. 따라서 메가와트당 초당 토큰 처리량은 수익 창출 능력을 좌우하는 핵심 지표가 되죠. 동일한 전력 범위에서 더 많은 토큰을 생성할수록 더 많은 수익을 창출할 수 있으며, 토큰당 비용이 낮을수록 수익성도 높아집니다.
SemiAnalysis AgentX 데이터에 따르면, NVIDIA Vera Rubin NVL72 시스템은 NVIDIA GB300 NVL72 대비 메가와트당 처리량이 30배 이상 높으며, DeepSeek V4 Pro 모델에서는 100만 토큰당 비용을 최대 45분의 1 수준으로 낮춥니다. 이러한 큰 폭의 성능 향상은 전체 스택에 걸친 ‘극한의 공동 설계(extreme codesign)’를 통해 구현되는데요. 이는 모델과 워크로드부터 소프트웨어, 컴퓨팅, 네트워킹, 메모리에 이르기까지 모든 요소를 하나의 시스템으로 함께 최적화한 결과입니다.
여기서 두 가지 질문이 뒤따릅니다. 먼저, 새로운 세대가 나올 때마다 토큰 비용이 크게 낮아진다면 컴퓨팅 수요도 감소할 것인가 하는 질문입니다.
답은 그렇지 않습니다. 오히려 컴퓨팅 수요는 확대되죠. 토큰 비용이 낮아지면 경제성을 확보하는 활용 사례가 더 많아지고, 이러한 새로운 활용 사례에서 소비되는 토큰은 효율성 향상으로 절감된 규모를 넘어섭니다.
두 번째는 내구성에 관한 질문입니다. 새로운 세대가 이전 세대보다 성능 향상을 거듭하면서, 기존 세대의 하드웨어가 어떻게 지속적으로 가치를 창출할 수 있는지에 대한 것이죠.
내구성: 기존 하드웨어의 지속적인 수익 창출
모든 워크로드에 최신 시스템이 필요한 것은 아닙니다. 워크로드의 복잡성과 특성에 따라 적합한 시스템이 다르기 때문에, 차세대 제품이 출시된 후에도 이전 세대 시스템이 지속적으로 수익을 창출할 수 있습니다.
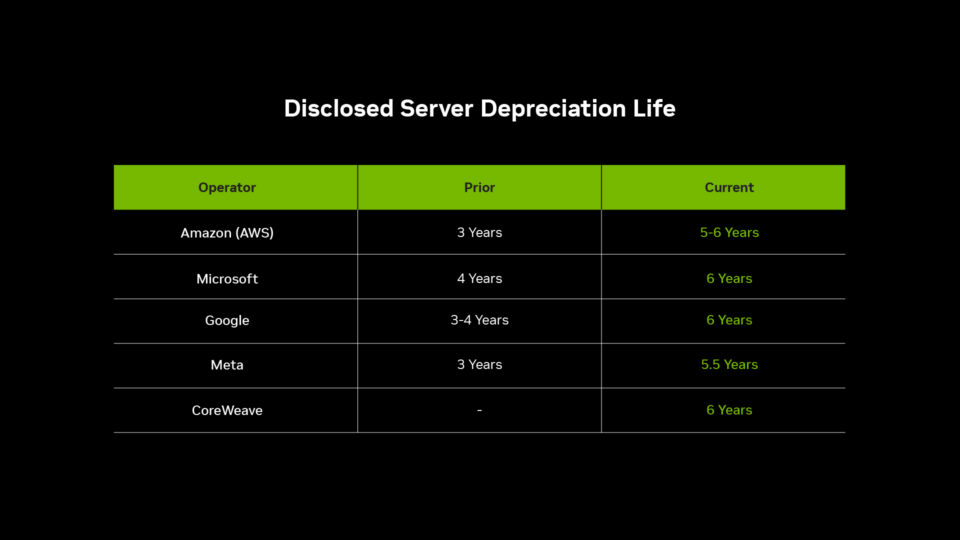
2020년 출시된 NVIDIA A100 GPU는 6년이 지난 지금도 상용 서비스에 활용되며 경제적 가치를 입증하고 있습니다. CoreWeave는 최근 2020년 처음 도입한 A100 GPU의 주문 기간을 2029년까지 연장했습니다. 주요 사업자들은 수년에 걸쳐 서버 감가상각 기간을 계속 늘려왔죠. 감가상각 기간은 하드웨어가 더 이상 수익을 창출하지 못하게 되는 시점을 가정한 것으로, 그 기간은 계속해서 늘어나고 있습니다. 2026년 9월 발표된 Sprout의 데이터센터 GPU의 생산적 수명(The Productive Life of a Data Center GPU) 분석은 모든 주요 사업자 전반에서 이러한 감가상각 기간이 어떻게 변화해왔는지 보여줍니다.
Barkr는 시스템의 중고 판매 가격을 바탕으로, 8개의 GPU가 탑재된 H100 시스템의 유효 수명을 5~6년, GB300 NVL72의 유효 수명을 9~10년으로 평가했습니다. Silicon Data에 따르면, 출시된 지 6년이 지난 A100 GPU는 여전히 초기 가격의 약 25%에 해당하는 가치를 유지하고 있습니다. 이는 5년의 감가상각 기간을 적용할 경우 이미 1년여 전에 가치가 0이 됐어야 한다는 점과 대비되죠. Ornn Data의 분석에서도 시장에서 A100 GPU를 5년 계약으로 임대할 때의 시장 가격이 1개월 계약 대비 약 80% 수준이라고 분석했습니다.
NVIDIA GPU를 프로그래밍하는 소프트웨어 플랫폼인 CUDA는 여러 세대에 걸쳐 호환됩니다. 따라서 새로운 아키텍처가 출시되더라도 운영자가 기존에 보유한 하드웨어의 활용 가치는 사라지지 않습니다. 또한 지속적인 소프트웨어와 커널 최적화를 통해 기존 하드웨어의 성능이 지속적으로 향상됩니다.
동일한 플랫폼에서 머신러닝, 딥러닝, 생성형 AI, 추론, 에이전틱 AI, 피지컬 AI 등 다양한 워크로드를 모두 실행할 수 있습니다. 새로운 유형의 작업 역시 기존 하드웨어에서 바로 수행할 수 있죠.
이것이 바로 범용성입니다. 하나의 시스템이 처리할 수 있는 작업의 종류가 다양할수록, 더 오랜 기간 활용될 수 있습니다.
범용성: 모든 유형, 단계, 환경에서 AI 구현
특정 작업 하나만을 위해 구축된 AI 팩토리는 해당 워크로드의 수요가 지속된다는 전제에 의존합니다. 반면, 다양한 워크로드를 실행할 수 있는 AI 팩토리는 작업이 변화하더라도 지속적으로 활용되며 수익을 창출할 수 있습니다.
NVIDIA AI 팩토리는 언어, 비전, 생물학, 물리학, 로보틱스 등 다양한 분야에서 오픈 모델과 독점 모델을 포함한 모든 유형의 AI 모델을 실행할 수 있습니다. 또한 데이터 처리부터 사전 학습, 사후 학습, 추론에 이르는 모든 단계를 지원하는데요. 하이퍼스케일과 AI 클라우드부터 소버린 프로그램, 기업 데이터센터, 엣지에 이르기까지 모든 환경에서 작동 가능합니다.
이러한 작업이 모두 AI 모델을 구축하고 실행하는 데만 사용되는 것은 아닙니다. 동일한 인프라에서 데이터 처리, 과학 컴퓨팅, 시뮬레이션, 그래픽 등 다양한 작업을 실행할 수 있습니다.
AI 여부와 상관없이 이러한 모든 워크로드는 동일한 병렬 연산을 기반으로 하며, NVIDIA GPU는 수천 개의 코어에서 이러한 연산을 동시에 처리하도록 설계됐습니다. CUDA를 통해 하나의 칩으로 빛을 시뮬레이션하고, 단백질 접힘을 분석하며, 다음 토큰을 예측할 수 있는데요. 그 위에는 1,000개 이상의 사전 구축된 CUDA-X 라이브러리가 제공되며, 심층 신경망부터 계산 리소그래피, 양자 회로 시뮬레이션, 벡터 검색, 기후 모델링에 이르기까지 다양한 영역을 지원합니다. 1,000만 명 이상의 개발자가 이를 기반으로 개발을 진행하고 있죠.
이러한 특성 덕분에 NVIDIA GPU는 단일 워크로드를 위해 설계된 맞춤형 ASIC이 아닌 범용 가속 컴퓨팅 플랫폼으로 활용됩니다. 여기서 범용성이란 단순히 일반적인 기능만 제공한다는 의미가 아닙니다. Tensor Cores와 Transformer Engine을 통해 프로그래밍 가능한 아키텍처에 AI에 최적화된 하드웨어를 결합함으로써, 단일 칩에서 전문성과 유연성을 동시에 제공하죠. 이 모든 것을 실행하는 단일 아키텍처 덕분에 활용도가 높게 유지되며, 그에 따른 높은 투자 수익도 보장됩니다.
이러한 범용성은 다양한 고객의 실제 운영 환경에서도 확인할 수 있습니다.
- Lilly: 1,016개의 GPU로 구성된 온프레미스 클러스터에서 단백질, 저분자, 유전체학 모델을 구축 및 운영하며, 자체 팀을 위한 챗봇과 에이전틱 워크플로우를 구축합니다.
- Pinterest: NVIDIA Blackwell, Hopper 및 이전 아키텍처를 아우르는 14,000개의 GPU로 구성된 하이퍼스케일 클라우드에서 비전 언어 모델을 사후 학습하고 배포하고 있습니다.
- Revolut: NVIDIA cuDF를 활용해 수십억 건의 거래 기록 데이터를 처리한 후, AI 클라우드에서 파운데이션 모델을 학습 및 배포합니다.
- Runway: NVIDIA Hopper에서 월드 모델을 학습하고, 클라우드 인프라를 활용해 NVIDIA Blackwell 플랫폼에서 서비스를 제공합니다.
- Texas A&M University: 슈퍼컴퓨터에서 분자 시뮬레이션과 AI 신약 개발을 수행하며, 26개 프로젝트와 7개 기관에 걸쳐 95~98%의 활용도를 기록하고 있습니다.
이러한 범용성은 AI 이외의 분야에서도 확인할 수 있습니다. Cosm은 NVIDIA 기반의 분산형 데이터센터를 운영하며, 고해상도 동영상 재생, 스트리밍, 실시간 그래픽, 동기화된 디스플레이 전반에 걸쳐 유연한 컴퓨팅 리소스를 제공합니다. Dassault Systèmes은 Wichita State의 항공기 인증과 Lucid Motors의 차량 설계에 활용되는 버추얼 트윈 시뮬레이션을 지원합니다. 또한 Unilever는 사진 촬영 대신 디지털 트윈을 활용해 제품 이미지를 제작함으로써 제작 비용을 절반으로 줄였습니다.
이처럼 NVIDIA AI 팩토리의 활용 범위는 특정 사례에 한정하기 어려울 만큼 폭넓습니다.
NVIDIA AI 팩토리는 높은 생산성, 내구성, 범용성을 갖추도록 설계됐습니다. 이를 통해 더 높은 수익성을 제공하는 토큰을 생성하고, 유효 수명을 연장하며, 보다 폭넓고 지속적인 수요에 대응할 수 있습니다. 이러한 특성이 AI 팩토리의 투자 수익을 극대화하죠.
여기서 10월 21일(수) 오전 11시(현지시간)에 진행되는 NVIDIA 젠슨 황 CEO의 GTC 베를린 기조연설을 시청하고, NVIDIA AI 팩토리에 대한 자세한 내용을 확인할 수 있습니다.