
NVIDIA 하이퍼스케일 및 고성능 컴퓨팅 부문 부사장 Ian Buck이 화요일 AI Infra Summit에서 AI 팩토리 효율성을 주제로 발표했습니다. 산타클라라 컨벤션 센터에서 열리는 이 행사는 어느새 인프라 기술 업계의 코첼라로 불릴 만큼 커졌죠.
지난해 3,500명에서 올해 8,000명 이상으로 늘어난 청중이 자리를 가득 메운 가운데, Ian Buck은 NVIDIA 플랫폼 전반의 새로운 협력 소식 등을 전했습니다.
- Amazon의 Annapurna Labs가 NVHBM 맞춤형 고대역폭 메모리 기술을 두고 NVIDIA와 협력하고 있습니다.
- d-Matrix는 NVLink Fusion과 통합해 NVIDIA Vera CPU와 d-Matrix Raptor XPU를 결합하고, 대규모 환경에서 초저지연 추론을 제공합니다.
NVIDIA와 파트너들은 새로운 성과도 함께 공개했습니다.
- Emerald AI와 NVIDIA가 Silicon Valley Power와 함께 상용 AI 팩토리 유연 부하 프로그램을 시연했습니다.
- Lambda는 NVIDIA DSX MaxLPS로 와트당 성능을 23% 끌어올렸습니다.
- Pinterest는 NVIDIA Blackwell 플랫폼과 NVIDIA Dynamo 추론 소프트웨어로 비주얼 디스커버리에 대화형 AI를 도입하고 있습니다.
이번 발표는 에이전틱 AI가 AI 인프라에 더 높은 성능과 효율성, 확장성을 요구하는 새로운 유형의 워크로드를 만들어 내고 있는 시점에 나왔습니다.
NVIDIA는 Vera Rubin 시스템과 Dynamo 추론 소프트웨어, NeMo 라이브러리, 그리고 NVIDIA 네트워킹을 아우르는 풀스택 AI 팩토리 플랫폼으로 이 과제에 답합니다. 네트워킹에는 스케일업 컴퓨팅을 위한 NVIDIA NVLink, 수천 개 노드를 연결하는 Spectrum-X 이더넷과 ConnectX SuperNIC, BlueField 기반 컨텍스트 메모리 스토리지, 인프라 보안을 담당하는 BlueField DPU가 포함되죠.
AI 인프라를 재는 잣대는 최대 성능에서 검증된 메가와트당 에이전틱 토큰으로 빠르게 옮겨 가고 있습니다. 이제 AI 팩토리는 실리콘부터 전력망까지 함께 설계돼야 하는데요. NVIDIA DSX MaxLPS는 팩토리 전체의 전력 최적화를 통해 메가와트당 토큰을 최대 1.4배까지 늘리고, NVLink는 대규모 가속 컴퓨팅을 하나의 고성능 시스템으로 묶어 줍니다.
그 결과 더 많은 토큰을 만들어 내고 효율을 높이며, 고객이 전력 1메가와트마다 더 큰 가치를 얻도록 돕는 AI 인프라가 완성됩니다.
9월 15일 화요일, 오전 9시 55분 PT 🔗
AI 팩토리 유연 부하 프로그램, 전력망 여유를 더 끌어내다
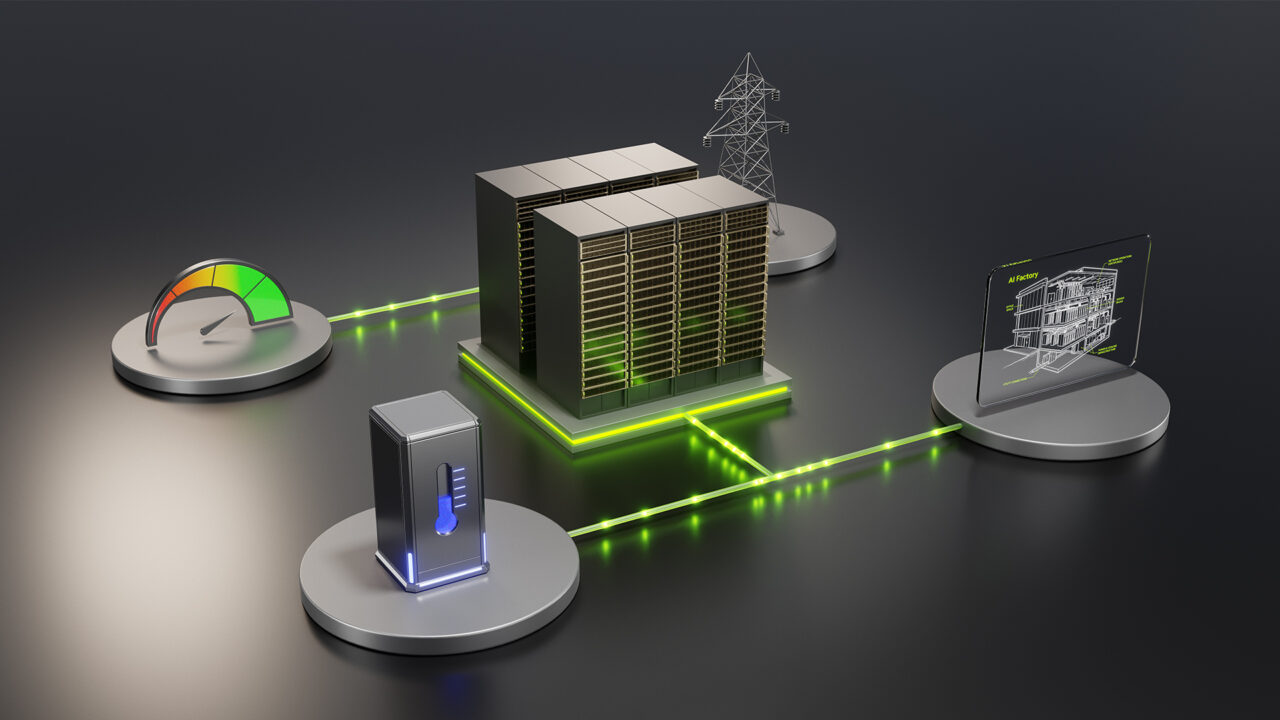
Silicon Valley Power는 AI 팩토리가 전력망의 유연성을 뒷받침할 수 있도록 하는 유연 부하 연계 프로그램을 운영하고 있습니다.
Emerald AI는 이 프로그램을 통해 NVIDIA와 함께 Silicon Valley Power 현장에서 자동 부하 저감을 시연했습니다. 이 시스템은 AI 워크로드 성능을 지키면서도 Silicon Valley Power가 보낸 수백 건의 수요 신호에 성공적으로 응답했죠.
NVIDIA 파트너 Emerald AI는 자사의 전력망 대응형 전력 관리 소프트웨어 Conductor에 NVIDIA DSX Flex를 활용할 계획입니다. Conductor는 실시간 전력망 신호와 하이브리드 에너지원에 맞춰 AI 팩토리의 에너지 소비를 동적으로 조정하는 소프트웨어죠.
DSX Flex로 자율 부하 분산을 수행하면서, Emerald AI는 우선순위가 낮은 AI 작업의 전력을 자동으로 낮췄다가 다시 정상으로 되돌리는 역량을 입증할 수 있습니다.
DSX Flex는 부하 차단 요청과 수요 반응 이벤트, 가격 신호 같은 전력망 신호를 받아 미리 정해 둔 워크로드 우선순위에 따라 자동으로 대응합니다. 가장 중요한 작업은 계속 돌아가고, 나머지는 잠시 멈췄다가 다시 이어지죠. 이런 방식으로 시설은 전력망의 에너지 효율에 기여할 수 있습니다.
이 역량 덕분에 AI 팩토리는 유연한 전력망 자원으로 작동할 수 있습니다. 전력망에 여유가 필요할 때 수요를 줄이고, 우선순위가 높은 AI 워크로드는 보호하며, 제어 가능한 AI 부하가 성장에 필요한 전력망 용량을 더 확보하는 데 도움이 된다는 사실을 증명하는 것이죠.
Emerald AI와 Silicon Valley Power의 협력에 대해 자세히 알아보세요.
9월 15일 화요일, 오전 9시 55분 PT 🔗
Lambda, NVIDIA DSX MaxLPS로 와트당 성능을 극대화하다
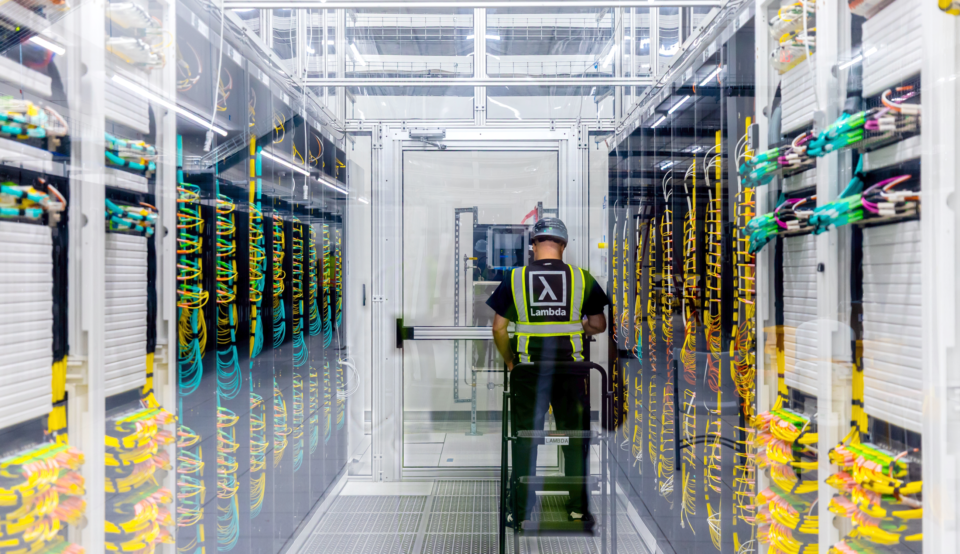
AI 클라우드 사업자 Lambda가 AI Infra Summit에서 결과를 공개하며, NVIDIA Blackwell 서버에서 NVIDIA DSX MaxLPS를 처음으로 검증했습니다.
DSX MaxLPS는 GPU와 랙 전반의 전력 소비를 계속 모니터링하면서 가용 전력을 가장 필요한 곳으로 동적으로 옮기고, 정적 프로비저닝이 남겨 둔 여유 용량을 되찾아 옵니다. 학습과 추론 워크로드는 전력 프로파일이 서로 다르기 때문에, MaxLPS는 워크로드가 뒤섞인 AI 팩토리 전반에서 전력 배분을 최적화하죠.
결과는 뚜렷했습니다. Lambda는 보통 풀파워 노드 16개에 배정되는 전력 예산 안에서 노드 19개를 구동해 클러스터 전체 토큰 처리량을 24%(초당 약 400만 개에서 500만 개로) 늘렸고, 와트당 성능도 23% 개선했죠. 차세대 NVIDIA Vera Rubin NVL72 AI 팩토리라면 적절한 배포 환경에서 DSX MaxLPS로 같은 메가와트 예산 안에서 GPU 용량을 최대 40%까지 더 확보할 수 있습니다.
결국 AI 팩토리 운영자는 동일한 전력 범위 안에서 AI 용량과 토큰 처리량을 늘려, 메가와트마다 생산성과 경제적 가치를 최대로 끌어올릴 수 있는 셈입니다.
Lambda의 상세 결과를 확인해 보세요.
9월 15일 화요일, 오전 9시 55분 PT 🔗
Vera Rubin과 Groq 3 LPX, 더 많은 전력을 토큰으로 바꾸다
AI 팩토리에서는 전력이 곧 제약입니다. 1와트도 허투루 쓸 수 없으니, 메가와트마다 토큰을 더 짜내는 것이 AI 인프라에서 가장 중요한 일이 됐죠.
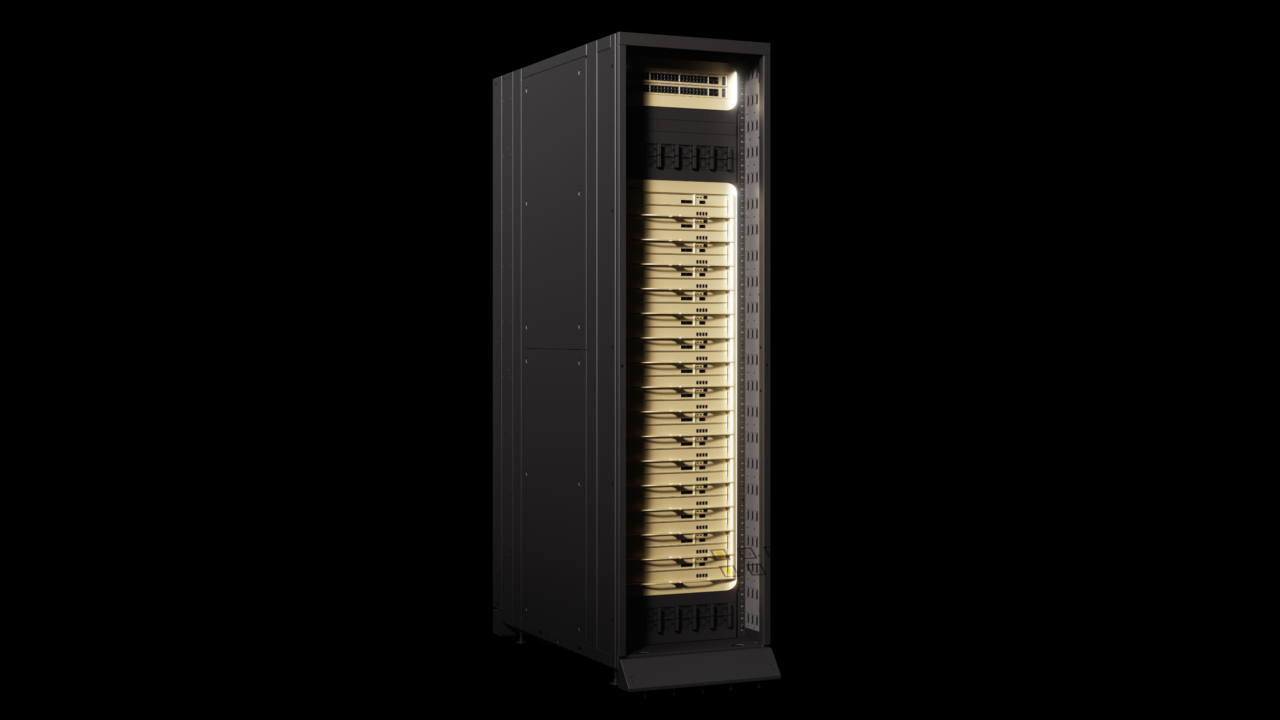
NVIDIA는 Vera Rubin NVL72 위에 세운 풀스택 AI 팩토리로 이를 해냅니다. 시스템과 네트워킹, 소프트웨어, 전력 관리가 하나처럼 움직이는 구조인데요. 팩토리 차원에서는 NVIDIA DSX MaxLPS가 수요가 오르내리는 흐름에 맞춰 랙 사이로 전력을 동적으로 옮깁니다.
효과는 분명합니다.
- 동일한 사이트 전력 범위 안에서 GPU 최대 40% 추가
- 토큰 처리량 최대 35% 향상 — 신규 전력선 불필요
각 랙 안에서는 Intelligent Power Smoothing 소프트웨어와 확장된 에너지 버퍼링이 짧은 스파이크를 흡수해, 시스템이 지속 수요에 더 가깝게 돌아가도록 해 줍니다. 묶여 있던 여유 전력이 생산적인 컴퓨팅으로 바뀌는 셈이죠.
에이전트가 추론 단계와 도구 호출을 사슬처럼 이어 가는 에이전틱 AI에서는 지연 시간과 컨텍스트 길이가 순식간에 불어납니다. NVIDIA Groq 3 LPX가 필요한 지점이 바로 여기인데요. Groq 3 LPX는 Vera Rubin에 결정론적 초저지연 추론을 더하면서 DSX MaxLPS를 보완합니다. 두 기술을 합친 플랫폼은 2조 개가 넘는 파라미터 모델을 긴 컨텍스트로 돌릴 때 GB200 NVL72 대비 메가와트당 토큰 처리량을 최대 35배까지 끌어올립니다.
숫자가 이를 말해 줍니다. 10만 컨텍스트의 Qwen 3.8 27B 워크로드에서 Groq 3 LPX는 사용자당 초당 2,529개의 출력 토큰을 기록했습니다. 이만큼 여유가 생기면 워크로드가 커져도 같은 응답 예산 안에서 에이전트가 더 많은 추론 단계와 도구 호출을 수행할 수 있죠.
NVIDIA Vera Rubin NVL72와 Groq 3 LPX가 어떻게 더 적은 전력으로 더 많은 토큰을 만들어 내는지 자세히 알아보세요.
9월 15일 화요일, 오전 9시 55분 PT 🔗
Vera Rubin NVL72, SemiAnalysis AgentX에서 AI 팩토리 처리량 30배 달성
SemiAnalysis AgentX는 단일 요청 벤치마크가 아니라, 실제 에이전틱 코딩 세션을 녹화해 컨텍스트 증가와 도구 호출 지연, 서브 에이전트 생성까지 그대로 살린 상태에서 추론 성능을 측정합니다. NVIDIA Vera Rubin NVL72의 에이전틱 성능 결과는 현재 SemiAnalysis AgentX 대시보드에 공개돼 있는데요. DeepSeek V4 Pro 모델에서 Vera Rubin NVL72는 NVIDIA GB300 NVL72 대비 메가와트당 처리량이 최대 30배 높았습니다.
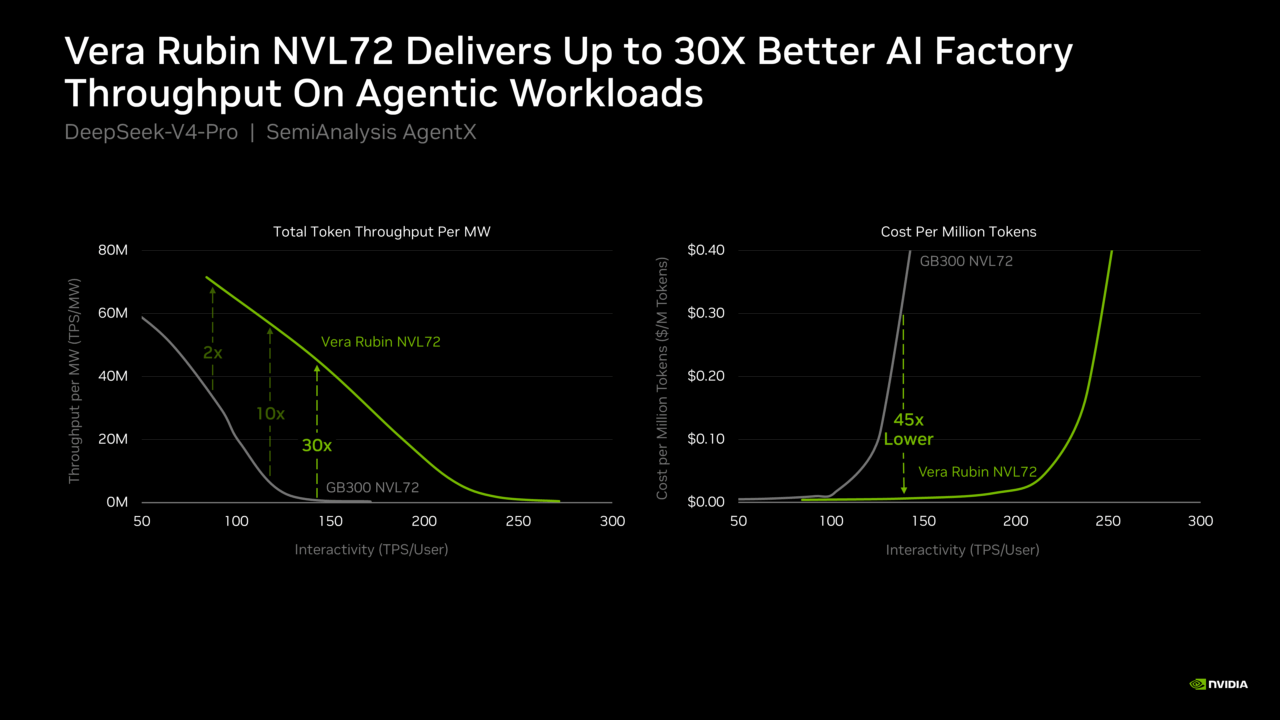
에이전틱 워크로드는 그동안 추론 벤치마크가 측정해 온 요청-응답 방식의 작업과 형태가 다릅니다. 에이전트가 추론하고 도구를 호출하며 서브 에이전트를 만들어 내는 동안 세션 하나에 수십만 개의 입력 토큰이 쌓이는데, 단순한 채팅 요청의 약 15배에 해당하는 분량이죠. 게다가 요청마다 입력과 출력 길이의 편차도 큽니다. 이를 처음부터 끝까지 담아내려면 에이전트의 전체 궤적을 중심으로 설계된 벤치마크가 필요한데, AgentX가 바로 그 역할을 하며 폭넓은 모델과 시나리오에서 요청 단위 성능을 재는 MLPerf Inference 같은 표준 제품군을 보완합니다.
이 효율 향상은 AI 팩토리의 수익성으로 곧장 이어집니다. 메가와트당 처리량이 최대 30배 높다는 것은 같은 에너지로 에이전틱 작업을 최대 30배 더 처리한다는 뜻이고, AgentX 결과에서는 100만 토큰당 비용도 최대 45배 낮게 나타났습니다. 전력이 제한된 배포 환경에서는 메가와트당 처리량이 AI 팩토리의 매출 규모를 결정하고, 100만 토큰당 비용이 그 마진을 좌우하죠.
이 성능은 극한의 코디자인이 만들어 낸 결과입니다. NVL72 스케일업 도메인과 6세대 NVLink 인터커넥트, 5세대 텐서 코어의 NVFP4 정밀도, 그리고 NVIDIA TensorRT LLM과 NVIDIA Dynamo를 아우르는 추론 스택이 함께 움직였죠. Vera Rubin은 이미 본격 양산에 들어가 생태계 전반으로 확산되고 있으며, 소프트웨어 최적화가 이어지면서 성능도 꾸준히 향상될 예정입니다.
이러한 결과를 뒷받침하는 플랫폼 아키텍처에 대해 자세히 알아보세요.
9월 15일 화요일, 오전 9시 55분 PT 🔗
스타트업들이 전한 NVIDIA Vera CPU 성능 결과
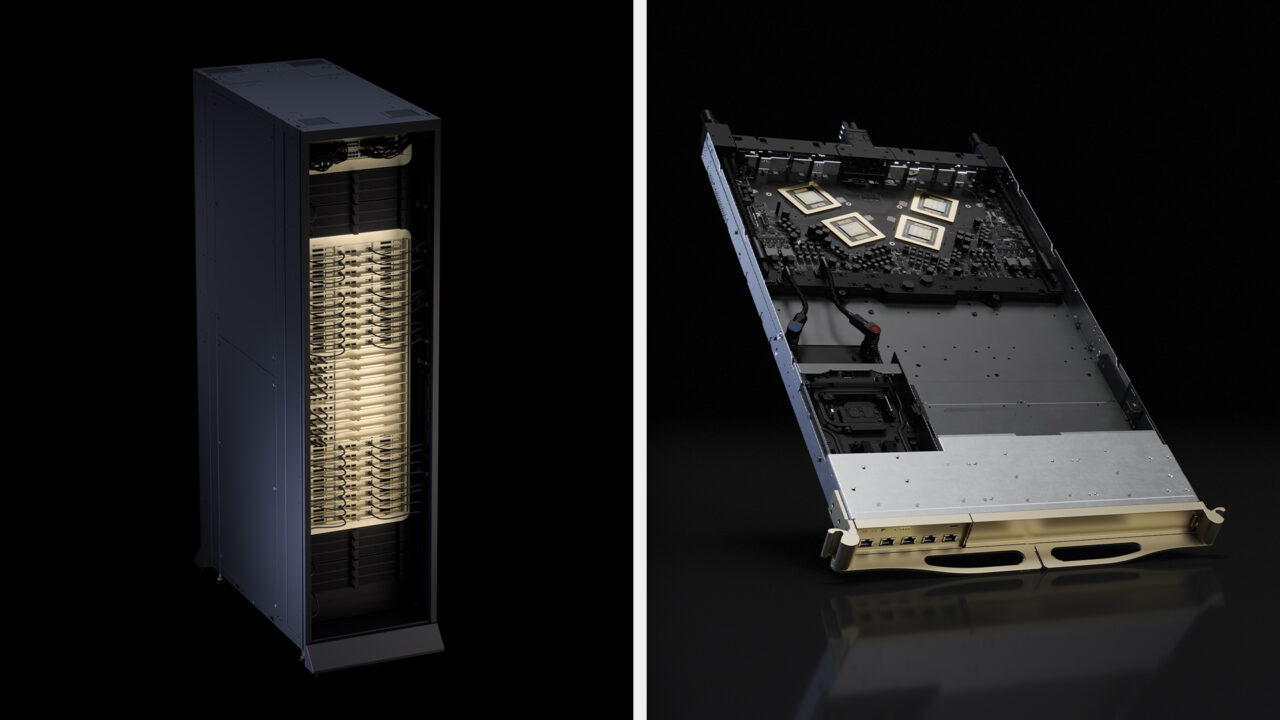
스타트업들이 에이전트 워크로드를 비롯한 고부하 애플리케이션에 NVIDIA Vera CPU를 적용해 시험하고, 그 결과를 잇따라 내놓고 있습니다.
Perplexity는 에이전틱 AI를 위한 새로운 보안 샌드박스 플랫폼 SPACE에 Vera CPU를 벤치마킹해 샌드박스 시작 속도가 1.9배 빨라졌다고 밝혔습니다.
Daytona는 에이전틱 워크로드로 Vera CPU를 시험한 뒤 “에이전틱 실행에서 상당한 성능 향상”을 언급했습니다.
ClickHouse는 분석용 데이터베이스 공개 벤치마크인 ClickBench에서 Vera CPU 결과를 공유했습니다. Vera는 이 팀이 지금까지 측정한 것 중 가장 빠른 머신이었는데요. ClickHouse는 “데이터 집약적 워크로드를 위한 CPU 성능이 앞으로 어떻게 전개될지 보여 주는 강력한 신호입니다”라고 평가했습니다.
DeepInfra는 Vera CPU로 여러 벤치마크를 돌려 오케스트레이션 단계 지연 시간이 2.2배 빨라지는 등 모든 지표에서 앞섰다는 결과를 내놨습니다.
Prime Intellect는 병렬로 실행되는 워크로드가 늘어나도 Vera CPU가 높은 대역폭과 낮고 일정한 메모리 지연 시간을 유지했다고 밝혔습니다. 에이전틱 AI에 필요한 예측 가능한 성능이 바로 이것이죠.
Redpanda는 Vera CPU 벤치마크에서 다른 CPU 대비 지연 시간이 5.5배 낮고 처리량은 73% 높았다고 밝혔습니다.
Starburst는 Vera CPU가 다른 CPU보다 쿼리 처리량이 3배 빨랐다는 벤치마크 결과를 공개했습니다.
Kinetica는 기존 CPU와 비교해 Vera CPU에서 분석 쿼리 성능이 2.7배 빨라졌다고 밝혔습니다.
9월 15일 화요일, 오전 9시 55분 PT 🔗
NVIDIA NVLink 6, 초대규모 AI 팩토리를 멈추지 않게 하다
AI 팩토리가 수십만 개 GPU 규모로 커지면서 안정성 자체가 하나의 성능 요소가 되고 있습니다.
학습과 추론 워크로드는 연속 가동에 의존하기 때문에, 일시적 오류와 신호 열화, 하드웨어 장애는 피할 수 없는 과제가 되죠. NVIDIA NVLink 6은 장애가 애플리케이션에 영향을 미치기 전에 이를 탐지하고 격리하며 복구하도록 설계된 다층 복원력 아키텍처로 이 과제에 대응합니다.
물리 계층에서는 맞춤형 순방향 오류 정정과 물리 계층 재시도, 범용 물리 계층 복구가 지연 시간 영향을 최소화하면서 무손실 패브릭을 유지하도록 돕습니다. 네트워크 계층에서는 크레딧 기반 흐름 제어와 동적 라우팅, 링크 재조정이 장애를 국소적으로 가두어 AI 팩토리 처리량을 떨어뜨리는 연쇄 정체를 막습니다.
NVIDIA NVLink 6에 대해 자세히 알아보세요.